周末的展厅里,一位老人在一件青铜鼎前站了很久,抬手想要问点什么,话到嘴边又咽了回去。这样的一幕,几乎每天都在博物馆里发生——讲解员忙不过来,自助讲解又千篇一律,不少人其实是带着好奇进来,又带着遗憾离开。
博物馆里收藏的,从来不只是一件件器物,更是一代代人的记忆与创造。那些青铜、陶俑、书画背后,藏着朝代更迭、制度变迁、风俗人情,是文明延续的根脉。讲解,正是把文物与观众连起来的那座桥——把年代、纹饰、制度、习俗背后的含义讲清楚,让展柜里的文物真正“活”起来。
如今走进博物馆的观众,胃口和从前大不一样了。他们不再满足于被动听一段讲解,而是希望内容贴着自己的兴趣来,有画面、能对话、有温度。个性化讲解,说白了就是根据观众的年龄、知识储备、兴趣偏好和参观目的,讲出不一样的内容、不一样的深度——既把受众面做大,也把内容讲准。可理想很丰满,现实里困难也不少:观众想听的摸不准,讲出来的怕失实,一问一答又太单调。这背后,恰恰是大语言模型可以大显身手的地方。
先说价值。传统讲解高度依赖讲解员,旺季人手不够,淡季又闲着;基层和偏远地区的博物馆,专业讲解员更是留不住,老人、孩子、残障朋友这些群体,常常得不到适合自己的讲解。大语言模型恰好能补上这块短板——它可以低成本、长时间地运行,不受开馆时间和地点的限制,观众随时都能听到一段像样的讲解;再加上多语种、多方言的支持,配合文字、语音、图像,无障碍服务也能更周全,让公共文化服务真正惠及更多人。
再看精准。一套讲解词从头讲到尾,儿童、青年、学者、外地游客面对同一件文物,想听的其实完全不同。大语言模型可以按年龄、知识基础、文化背景来调整讲法:给孩子讲成故事,给青少年讲清来龙去脉,给研究者补上前沿观点,给不同地域的观众结合他们的生活经验来讲。观众听得懂、记得住,历史误读自然变少,普通人和传统文化之间,也就不再那么有“隔阂”。
还有一层,是让文物“活”起来。过去的讲解,多停在年代、材质、工艺这些“看得见”的信息上,文物背后的故事和文明脉络反而容易被忽略。大语言模型能把历史典故、民俗、信仰、审美这些零散材料串起来,讲成一条连贯的线索——观众不只看器物,更明白它从哪来、为什么重要。配上语音、图像和虚拟场景,静态的文物就变成了可听可感的场景,参观也更有代入感;多语种翻译,又能让中华文化走向海外。对许多承载着民族交往交流交融记忆的文物,模型也能梳理其中的线索,把各民族共同创造、共同守护的根脉讲清楚,为铸牢中华民族共同体意识添一份实实在在的助力。
对博物馆人来说,这件事的意义还不止于省下几个人力。文物的价值,一部分在器物本身,另一部分在它承载的故事;讲得好不好,直接决定观众心里能留下什么。把AI用好了,等于给每位观众都配了一位知识可靠、又有耐心的讲解员。
不过,理想和落地之间还有不小的距离。眼下不少博物馆的AI讲解还停留在语音播放、简单问答的层面。系统识别观众,靠的多是年龄、性别这些浅标签,判断不了观众懂多少历史、对什么感兴趣、来自什么文化背景——头一回来的游客和常逛文博场馆的老朋友,常常被当成同一类人。内容也不够灵活,多是预设好的语音和固定文本,观众抛出预设之外的问题,就答不上来。靠标签分类的做法,谈不上真正的个性化。
历史类博物馆的讲解,头一条要求就是准确。历史牵涉朝代更迭、制度演变、社会风俗,一句话含糊,观众就可能理解偏。历史资料的信息分散,来自考古报告、地方志、学术著作等,大语言模型若没有可靠的来源约束,很容易编出似是而非的内容,曲解史实和风俗。现在的不少AI讲解,也只讲表面特征,不碰文物背后的精神内涵,观众记住的是一堆零散标签,而不是一段鲜活的历史。一旦审核缺位,片面甚至错误的表述扩散出去,误导的就是公众的历史认知,文化传播的风险也就跟着来了。
还有情感这一关。传统讲解是讲解员讲、观众听,双向交流的空间本就不大。今天的AI讲解,大多也沿用这个单向思路——表面上能对话,实际只能处理简单问题,观众追问一件文物的来历和背景,回答就容易生硬,甚至绕开问题。合成语音能模仿人声,却很难有情绪起伏。讲解不只是传递知识,还要让观众有代入、有共鸣。面对承载着王朝兴衰、民族交融记忆的展品,一段冷冰冰的语音会冲淡现场氛围,也拉开观众和历史的距离。
要破这个局,不外乎解决三件事:讲给谁、讲得准、讲得活。
讲给谁,是对用户画像的精准匹配。在合规的前提下,系统采集年龄段、参观路线、停留时长、提问内容、兴趣选择、文化背景等信息,避开能定位到个人的敏感数据,汇成动态的用户画像,判断观众大致懂多少、偏好哪类内容。观众在展厅里的停留、追问、跳过,都会反馈回系统,随时调整后面的讲解。基础层讲清楚名称、用途和样子,进阶层补充时代背景和历史价值,专业层延伸到学术研究,讲法随之切换。
上海博物馆东馆的做法值得一看。2026年5月,这里上线了AI眼镜智能导览:观众租借眼镜后,设备依托智能感知算法,实时捕捉游览轨迹、停留时长、互动偏好,结合年龄特征自动匹配逛展风格,精准推送适配个人兴趣的展品与展区。观众频繁在青铜器前驻足,它便自动推送同年代、同类型的相关文物。同一件展品,还会按年龄段自动给出“成人深度版”和“儿童趣味版”两种讲法——成年人听深度历史解析,孩子听趣味故事。当观众在核心展品前停下,讲解便自动开启,无需手动操作。
讲得准,是基于知识图谱增强的叙事重构。考古报告、学术文献、地方档案、出土文献、非遗记录都予以纳入,标注来源,把人物、制度、器物、事件拆成实体、属性和关系,建成能溯源的中华历史文化知识图谱;有争议的内容单独标出、附多方注解,不靠模型瞎编,图谱还随新发现不断更新。观众提问时,系统先到图谱里取可靠片段,再让大模型组织成语言,记住上下文,追问几轮也能把零散信息串成完整的叙事。考古、历史、文博专家参与图谱建设和内容把关,专家做最终判断,意见回流知识库,逐步纠正模型的偏差。
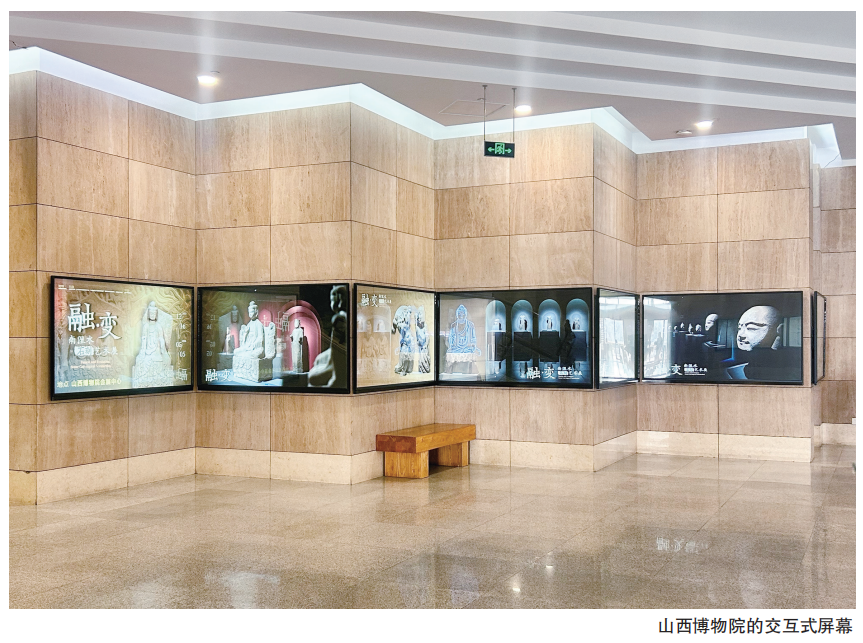
山西博物院把“文物知识图谱”放进了展厅。一层大厅里,数块交互式屏幕组合成十多米长的“魔屏”——借助文物数据智能关联、历史脉络可视化等技术,展现文物的历史时间轴和关系图谱。观众轻触屏幕,就能放大文物三维影像,看清它与其他文物、人物、事件之间的关联。在内蒙古博物院,依托空气投影与交互技术打造的AI讲解员“疆格尔”,可与观众实时对话:观众开口提问,她便能娓娓讲述馆藏文物。讲解不再孤立介绍单件文物,而是循着历史脉络,带观众读懂成组文物背后的故事。
讲得活,是多模态人机协同的沉浸式交互。语音合成不只求发音清楚,还讲究停顿、轻重和语气,让讲解听起来像有人在认真讲;通过提问内容和语速语调,系统能察觉观众的状态——有兴趣就多讲,累了就放慢、讲得直白些。AR、VR可以复原古代生活、礼乐仪式,让观众更容易“走进”那个时代。文博虚拟数字人也要有文化的样子,形象、服饰、表情都从传统元素里来,不只是一个空壳。落脚点仍是人机协同:大语言模型负责基础讲解、答疑、推荐这些重复性工作,讲解员腾出手来,做好深度阐释和现场引导。
当前,国内多家博物馆已经和豆包合作,推出了豆包App里的“博物馆讲解”模式。2026年5月,在第50个国际博物馆日,这一模式正式上线,首批官方合作便覆盖中国国家博物馆、首都博物馆、甘肃省博物馆等20余家博物馆、美术馆。观众打开豆包App,把手机对准一件展品,它便能自动识别,给出专业又有个性的讲解;它能连续对话,观众想怎么问就怎么问,还支持武汉话、粤语、四川话等12种方言,本地观众用乡音就能和文物聊起来。
说到底,个性化讲解不是要让机器取代讲解员,而是想给每一位观众配一位“懂自己”的讲解员。既把观众想听的讲到心坎里,也守住历史真实这条底线,让讲解更有趣味和温度。以后,博物馆要做的事更多:继续完善历史文化数据库,健全内容安全机制,理清人和机器的分工,让大语言模型在可靠的边界里发挥所长。到那时,每一件文物背后那段鲜活的历史,才能真正被更多人听懂、记住、传下去。
(作者单位:山西博物院)